AnimeGenとは?無償公開の国産アニメ動画AI

画像出典: AIdeaLab株式会社(公式note)
AnimeGenは、AIdeaLab株式会社が2026年7月13日に無償・商用利用可で正式公開した、アニメ表現に特化した動画生成AIです。ライセンスはApache License 2.0で、モデル本体がHugging Faceで公開されており、ブラウザ上のデモでも試せます。中国Alibabaのオープンな動画生成モデル「Wan 2.2」をベースにアニメ調の映像へ追加学習したもので、フレーム間でキャラクターの見た目が変わる・ちらつくといった、動画生成AI共通の「時間方向の一貫性」の限界は残っています。
無償公開・商用利用可というのは、報道と公式のモデルカードで確認できる事実です。2026年7月13日、東京の国内AIベンチャーであるAIdeaLab株式会社が、アニメ表現に特化した動画生成AI「AnimeGen」を正式公開しました。国内企業による国内初のアニメ特化動画生成AIの公開として報じられています。
ただ、こういうニュースを見て気になるのは「で、自分が使えるものなのか」「どこまで自由に使えるのか」あたりではないでしょうか。それと、動画を作るAIは画像を作るAIと何が違うのか。正直なところ、ここが分かると生成結果を見たときの納得感がまるで変わります。順番に見ていきます。
AnimeGenとは?何が公開されたのか
AnimeGenは、AIdeaLab株式会社が開発したアニメ調の映像に特化した動画生成AIです。ベータ版が2025年10月に公開され、約半年間のベータテストを経て、2026年7月13日に正式公開されました。
公開されたのは次の3つです。テキストから動画を作るText to Video(T2V)、手持ちの画像を動かすImage to Video(I2V)、そしてコマとコマの間を埋めて滑らかにするフレーム補間(Frame Interpolation)。この3つが揃っているのは、「ゼロから作る」だけでなく「すでにある絵を動かす」用途も想定されているということです。
- 開発元: AIdeaLab株式会社(東京都千代田区)
- 公開日: 2026年7月13日に正式公開(ベータは2025年10月)
- 費用: 無償
- ライセンス: Apache License 2.0(商用利用可)
- 提供形態: Hugging Face(AIモデルを公開・共有する海外の大手プラットフォーム)でモデル本体を公開、ブラウザ上のデモあり
- 公式サイト: animegen.jp
開発の背景として、AIdeaLabは「アニメ表現に特化したAI技術の開発において、日本は海外に比べて遅れているのが現状」と指摘し、制作現場のAI活用によって人手不足や長時間労働の課題を解決したいとしています。実際、同社は「2024年当初はアニメ領域で十分に高品質な生成は簡単ではなかった」とも述べていて、この2年ほどで状況が動いたことがうかがえます。
もうひとつ押さえておきたいのが、これが完全な民間単独の成果ではないという点です。経済産業省と国立研究開発法人新エネルギー・産業技術総合開発機構(NEDO)が実施する生成AI開発支援プロジェクト「GENIAC」の支援を受けて開発されています。国の生成AI支援プログラムの成果物が、誰でも使えるオープンライセンスで出てきたという構図です。
無料で商用利用できる、の「できる」はどこまで?
ここが一番誤解されやすいところなので、先に整理します。AnimeGenのライセンスはApache License 2.0です。オープンソースのライセンスとしては制限が緩い部類で、一般に改変・再配布・商用利用が認められ、著作権表示やライセンス文の保持といった義務が課される程度にとどまります。
報道でも「無償・商用利用可」と明記されており、企業が仕事の中で使うことを想定した公開だと読めます。制作会社が自社サーバーにモデルを置いて、社内のワークフローに組み込む――そういう使い方が想定内、ということです。
生成物にクレジット表記を求めるといったAnimeGen固有の追加条項があるかどうかは、公開されている一次情報からは確認できません。仕事で使う前には、必ずご自身でHugging Faceのモデルカード(モデルの仕様や利用条件が書かれた説明ページ)と公式サイトの記載を確認してください。
学習データについても、AIdeaLabは「日本の著作権法に基づいて収集・利用した」と説明していますが、データセットの具体的な出典や件数は公開されていません。ここは現時点で分かっていない、というのが正確な状態です。
もうひとつ現実的な話をすると、無償とはいえ動かす環境のコストはかかります。モデルカードではNVIDIA RTX 4090以上のGPUが推奨とされています。手元にそのクラスのマシンがない場合は、まずブラウザで動くデモから触ってみるのが現実的です。
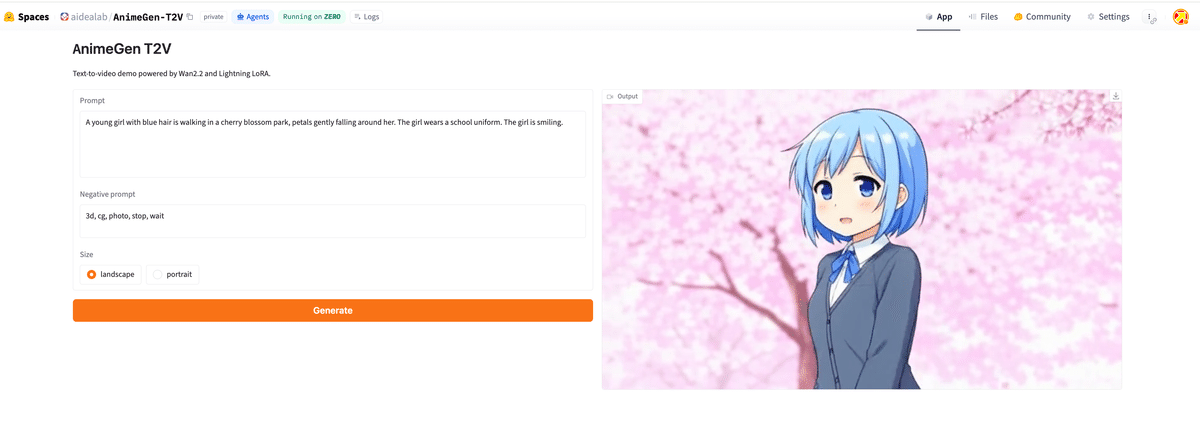
画面はかなり素直な作りです。左上のPrompt欄に作りたい映像を英文で書き、その下のNegative prompt欄に「入れたくない要素」を並べます。デモでは 3d, cg, photo といった語が入っていて、アニメ調から外れる方向をあらかじめ打ち消す使い方になっています。あとは画面の向き(横長・縦長)を選んでGenerateを押すだけ。右側に結果の映像が出てきます。
中身は何でできている? Wan 2.2ベースという事実
AnimeGenはゼロから作られたモデルではありません。中国Alibabaが公開しているオープンな動画生成AI「Wan 2.2」(Wan-AI/Wan2.2-T2V-A14B、14Bパラメータ級)をベースに、アニメ調の映像表現に特化するよう追加学習したモデルです。
この「ベースモデル+追加学習」という作り方は、今のAI開発ではごく一般的です。言語や映像の一般的なルール――物が落ちること、人の輪郭が続くこと――を学ぶには膨大な計算資源がいります。そこはすでに公開されているモデルに任せ、自分たちは「アニメらしさ」という上澄みの部分を教え込む。オープンライセンスのモデルが公開されていることが、そのまま国内開発の足場になっているわけです。
技術面では、Mixture of Experts(MoE、専門家混合)という構成が採られている点が挙げられています。これは、1つの巨大なモデルに全部を任せるのではなく、役割の異なる複数のモデル(専門家)を用意して、場面に応じて使い分ける仕組みです。AnimeGenは2つの専門家モデルを使い分けて品質を上げていると説明されており、動画生成でMoEを採用したのは世界初とされています(MoE構成自体はベースのWan 2.2が採用している技術です)。
生成できる映像のスペック
公式のモデルカードには、実際に生成できる映像の仕様が記載されています。
| 推奨解像度 | 832×480(最大1280×720) |
|---|---|
| フレームレート | 16fps |
| 生成長 | 最大5秒程度が例示 |
| 動作環境 | Diffusersライブラリ(WanPipeline)/NVIDIA RTX 4090以上を推奨 |
AIdeaLab(Hugging Faceモデルカード)の公表データをもとに作成
数字を見ると、今の動画生成AIが得意なのは「数秒のカット」であって「1本のアニメ」ではないことが分かります。5秒・16fpsということは、1回の生成でおよそ80枚の絵を、互いに矛盾しないように作っているという意味です。なぜそれが難しいのか、次に見ていきます。
なお、AnimeGen自体のパラメータ数は公式に公表されていません。ベースのWan 2.2が14Bパラメータ級である、というところまでが確認できる事実です。
なぜ動画生成AIは「絵を並べるだけ」では作れないのか
1枚ずつ独立に作って並べる方式は、実際に試すと破綻します。ここを理解するのに、パラパラ漫画を思い浮かべてください。100枚のパラパラ漫画を、100人の絵描きさんに1枚ずつバラバラに描いてもらったらどうなるでしょう。それぞれの絵は上手でも、髪の色が少し違う、服のボタンの数が変わる、背景の木の位置がずれる。めくった瞬間に、絵がガタガタと暴れます。
画像生成AIは基本的に「1枚の絵として自然か」を目指して作ります。ところが動画で問われるのは「隣り合うコマ同士が矛盾していないか」という別の基準です。この、時間の流れに沿って同じものが同じであり続ける性質を時間方向の一貫性と呼びます。動画生成AIの技術的な難所は、ほぼここに集約されます。
一貫性が崩れると何が起きるか
AnimeGenについても、PC Watchが具体的な限界を明記しています。フレーム間でキャラクターの見た目が変化したり、時間方向のちらつきが発生したりするという制限です。これはAnimeGen固有の弱点というより、現在の動画生成AIが共通して抱えている課題が、正直に書かれているものと読むのが妥当です。
- キャラクターの顔立ちや髪色が、途中のコマで微妙に変わる
- 細部(手の指、アクセサリー、服の模様)がコマごとに揺れる
- 画面全体が細かく明滅する「ちらつき」が出る
- 背景の物の位置や形が、動きに合わないかたちでずれる
アニメ調の映像では、この問題がとりわけ目立ちます。実写なら質感のノイズに紛れる程度のブレも、輪郭線とベタ塗りで構成されるアニメでは「線が震えている」としてはっきり見えてしまうからです。アニメ特化のモデルをわざわざ追加学習で作る意味は、絵柄を寄せることだけでなく、この見え方の厳しさに合わせ込むことにもあります。
だから、モデルは映像をまとめて作る
この課題への対処が、先ほどの「最大5秒」という仕様につながります。今の動画生成モデルは、1コマずつ順番に描くのではなく、数秒分のコマ全体を一つのかたまりとして同時に生成します。最初から最後まで見渡しながら描くので、途中で設定を忘れにくくなる。逆に言えば、一度に見渡せる長さには限りがあり、そこが生成時間の上限を決めています。
Image to Videoとフレーム補間が一緒に提供されている理由も、ここから見えてきます。Image to Videoは「この絵の通りにしてください」という出発点を人間が固定するやり方で、キャラクターがぶれる余地をあらかじめ減らせます。フレーム補間は、少ないコマの間を後から埋めて滑らかさを足す工程です。一貫性は完全自動では解けないので、人が押さえどころを与えて分業する――3つの機能が揃っているのは、そういう設計思想の表れだと考えると腑に落ちます。
今、これをどう受け止めればいいか
実際に触ってみるところまでのハードルは、かなり低い状態です。
- まずブラウザのデモで触るHugging Face Spaces(ブラウザ上でAIモデルを試せる公開スペース)で、T2V・I2V・フレーム補間の3つがそれぞれ公開されています。GPUを用意しなくても、生成の質と限界を自分の目で確かめられます。
- プロンプトとネガティブプロンプトの効き方を見るデモ画面の構成のとおり、「入れたいもの」と「打ち消したいもの」を両方書きます。ちらつきや破綻がどんな条件で出るかを、短いカットで観察してみてください。
- 仕事で使うならライセンス条件を自分で読むApache License 2.0であることは公表されていますが、追加条項の有無は一次情報からは確認できません。Hugging Faceのモデルカードと公式サイト(animegen.jp)の記載を、判断の前に必ず自分で確認します。
- 本格運用は環境コストを見積もるモデル本体はダウンロードできますが、推奨はNVIDIA RTX 4090以上。無償なのはモデルであって、計算資源ではありません。
現時点のAnimeGenは、数秒のカットを生成するツールです。1本のアニメを通しで作れるものではありませんし、フレーム間でキャラクターの見た目が変わる・ちらつくという限界も公表されています。「完成品を出してくれる装置」ではなく「素材やラフを高速に出す道具」として見たほうが、現実に近いです。
まとめると、AnimeGenのニュースが面白いのは「国産アニメAIが出た」という一点ではありません。海外のオープンモデルを土台に、公的支援を受けた国内チームが、成果を再びオープンライセンスで返したという循環が起きていることです。そしてその成果物には、動画生成AIが今どこまで来ていて、どこで止まっているかが、限界の記述も含めて素直に書かれています。触って確かめられる形で公開されているうちに、一度自分の目で見ておくと、次に出てくるモデルの評価がぐっと速くなります。
よくある質問
AnimeGenは無料で使えますか?
はい。AnimeGenはAIdeaLab株式会社が2026年7月13日に無償で正式公開しており、モデル本体はAIモデルを公開・共有するプラットフォームHugging Faceからダウンロードできます。ブラウザ上で試せるデモも提供されています。ただし自分の環境で動かす場合はNVIDIA RTX 4090以上のGPUが推奨されており、計算環境のコストは別途かかります。
AnimeGenで作った動画は商用利用できますか?
AnimeGenのライセンスはApache License 2.0で、商用利用も許諾されると公表されています。Apache License 2.0は一般に改変・再配布・商用利用を認め、著作権表示の保持などの義務が課される程度の緩やかなライセンスです。ただし生成物のクレジット表記義務など、AnimeGen固有の追加条項の有無は公開情報からは確認できないため、業務利用の前にHugging Faceのモデルカードと公式サイトの記載を必ず自分で確認してください。
動画生成AIの「時間方向の一貫性」とは何ですか?
時間方向の一貫性とは、動画を構成する連続したコマの間で、同じキャラクターや背景が同じ姿を保ち続ける性質のことです。画像生成AIは1枚の絵として自然かを目指しますが、動画では隣り合うコマ同士が矛盾しないことが求められるため、別種の難しさが生じます。一貫性が崩れると、キャラクターの見た目がコマごとに変化したり、画面が細かく明滅するちらつきが発生します。AnimeGenについてもこうした制限が公表されています。
AnimeGenはどんな仕組みで作られているのですか?
AnimeGenは、中国Alibabaが公開しているオープンな動画生成AI「Wan 2.2」(Wan-AI/Wan2.2-T2V-A14B、14Bパラメータ級)をベースに、アニメ調の映像表現に特化するよう追加学習して作られたモデルです。役割の異なる複数のモデルを場面に応じて使い分けるMixture of Experts(専門家混合)という構成が採られており、2つの専門家モデルを使い分けて品質を高めていると説明されています。開発は経済産業省とNEDOによる生成AI開発支援プロジェクト「GENIAC」の支援を受けて行われました。
※記事で使用した内容・数値は変更される場合があります。最新情報は公式サイトをご確認ください。